MLA
多头潜在注意力压缩键值缓存,在长上下文推理中减少显存与带宽压力。
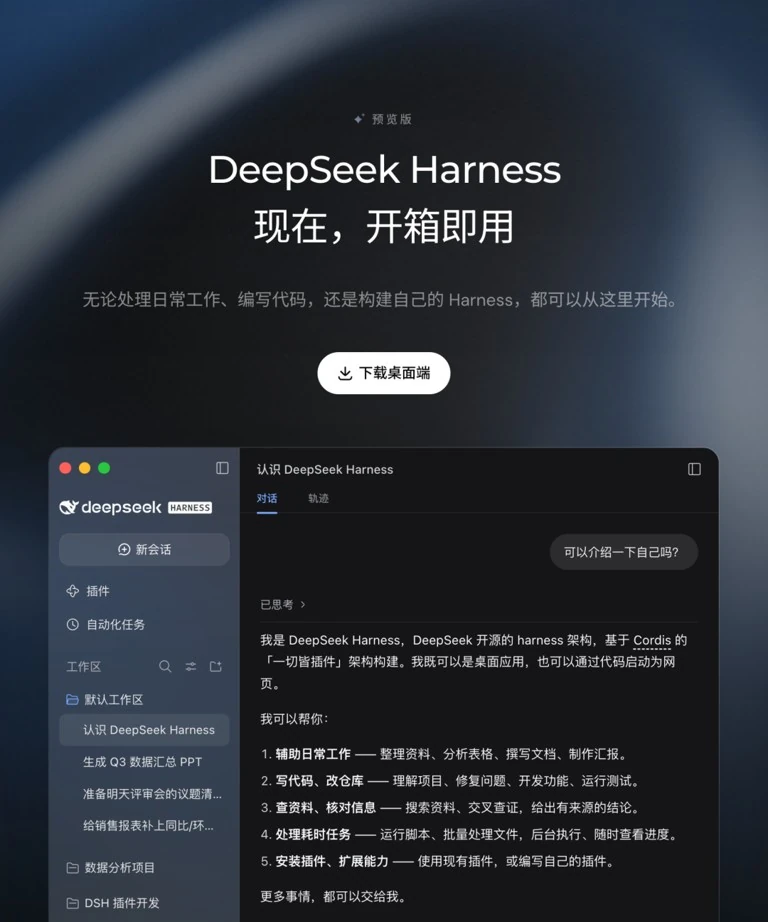
从 DeepSeek网页版 开始连续对话,经由 API 开放平台接入产品,再用 Harness 评测记录准确率、时延与成本。答案即终点,推理过程才是可复用的知识资产。
四项能力不是装饰词,而是模型处理长文本、复杂推理与低成本推断时的工程支点。
多头潜在注意力压缩键值缓存,在长上下文推理中减少显存与带宽压力。
通过可验证反馈训练推理策略,让模型在数学、代码与逻辑任务中学习复核路径。
稀疏激活不同专家网络,将模型容量与单次推理开销分开规划。
面向长文档、仓库级代码与连续会话,保留更完整的任务线索。
每项任务都从边界、输入与验收条件开始,不把提示词写成许愿清单。
梳理依赖、定位风险、拆分模块,并补齐可执行测试。
拆解命题、列出引理,逐步验证推导中可能遗漏的条件。
归纳长篇材料中的交易结构、义务条款与冲突信息。
将假设翻译为指标、约束与回测代码,标注数据偏差。
规划工具调用顺序,保留状态,并对失败步骤进行重试。
按显存、吞吐与隐私边界选择蒸馏模型和推理框架。
在开放平台管理凭据,并使用环境变量保存,不写入前端源码。
依据任务难度、上下文长度、延迟目标和预算确定调用策略。
保存请求版本、测试集与关键指标,使上线结果可以复现。
按任务选择入口。临时对话走网页端,系统集成走 API,质量验收走 Harness。
$ deepseek-harness run \
  --suite reasoning-cn \
  --model candidate \
  --metrics accuracy,latency,cost

[01/60] prompt locked
[42/60] revision detected
[60/60] report sealed

PASS  accuracy: 0.998
NOTE compare before release保存提示模板、采样参数、模型标识和数据集版本,避免结果漂移后无法解释。
将准确率、人工复核、首字延迟、总耗时和 Token 成本放入同一份记录。
不需要。本地页面通过站内“网页版入口”进入演示工作区;部署到正式站点后,可按实际服务地址配置入口。
先确定数据边界、鉴权方式、超时重试、日志脱敏与预算,再进行最小调用验证。
适合有固定输入和验收标准的数学、代码、抽取、分类、Agent 工具调用及长文档任务。
复杂多步推理优先考虑推理模型;高频通用任务关注吞吐与成本;离线场景按设备资源选择蒸馏尺寸。